反向传播算法#
反向传播的本质:信用分配#
神经网络训练时,我们根据最终损失来调整参数。核心问题是:损失是由很多参数共同造成的,每个参数该"背多少锅"?
反向传播(Backpropagation)[RHW86] 就是解决这个 "信用分配问题"的高效算法。
类比:团队项目的责任分摊
想象一个团队项目失败了(损失很大),需要找出每个人的责任:
前向传播:项目执行过程,每个人完成自己的任务
反向传播:从失败结果倒推,计算每个人对失败的责任(梯度)
链式法则:如果A的工作影响了B,B的责任要按贡献度传递给A
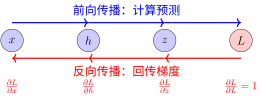
反向传播:梯度从输出流回输入
链式法则:梯度的传递机制#
反向传播算法的核心是链式法则(Chain Rule),这是微积分中复合函数求导的基本法则。想象你改变了输入 \(x\) 一点点,这个变化会层层传递,最终影响损失 \(L\)。链式法则告诉我们:总的影响是各层影响的乘积。
回顾 计算图 中讨论的计算图概念:神经网络可以被看作是一个由许多简单操作(加法、乘法、激活函数等)组成的图。反向传播正是沿着这个图的边,将梯度从输出传递回输入。
对于复合函数 \(z = f(g(x))\),如果 \(x\) 变化了 \(\Delta x\):
首先影响 \(g\):\(\Delta g \approx \frac{\partial g}{\partial x} \Delta x\)
然后影响 \(z\):\(\Delta z \approx \frac{\partial z}{\partial g} \Delta g\)
综合起来:\(\Delta z \approx \frac{\partial z}{\partial g} \cdot \frac{\partial g}{\partial x} \cdot \Delta x\)
所以:
直觉:影响会层层叠加——就像多米诺骨牌,第一块倒下的角度(\(\frac{\partial g}{\partial x}\))乘以第二块倒下的角度(\(\frac{\partial z}{\partial g}\)),就是最后一块倒下的总角度。
从标量到向量:Jacobian 矩阵#
上述链式法则适用于标量函数。但在神经网络中,每一层的输入和输出都是向量(几百甚至几千个神经元的值),而不是单个数字。所以我们需要一个推广版的导数——Jacobian 矩阵。
从标量导数到 Jacobian
概念 |
数学表示 |
输入维度 |
输出维度 |
矩阵形状 |
|---|---|---|---|---|
标量导数 |
\(\frac{df}{dx}\) |
1 |
1 |
1×1 |
梯度 |
\(\nabla f = [\frac{\partial f}{\partial x_1}, \frac{\partial f}{\partial x_2}, ...]\) |
N |
1 |
1×N 行向量 |
Jacobian 矩阵 |
\(\frac{\partial \mathbf{h}}{\partial \mathbf{x}}\) |
N |
M |
M×N 矩阵 |
每个元素 \((i,j)\) 的意思:“第 \(j\) 个输入变一点点,第 \(i\) 个输出变多少”。
形状:\((\text{输出维度}) \times (\text{输入维度})\)。
定义:Jacobian 矩阵#
对于向量值函数 \(\mathbf{f}: \mathbb{R}^n \rightarrow \mathbb{R}^m\),其 Jacobian 矩阵 \(\mathbf{J} \in \mathbb{R}^{m \times n}\) 定义为:
每个元素 \(J_{ij} = \frac{\partial f_i}{\partial x_j}\) 的含义是:第 \(j\) 个输入变化一点点,第 \(i\) 个输出变化多少。
维度规则:Jacobian 的形状是 \((\text{输出维度}) \times (\text{输入维度})\)。
神经网络中的例子:
一个全连接层 \(\mathbf{h} = W\mathbf{x} + \mathbf{b}\):
输入 \(\mathbf{x} \in \mathbb{R}^{100}\)(100维)
输出 \(\mathbf{h} \in \mathbb{R}^{64}\)(64维)
权重 \(W \in \mathbb{R}^{64 \times 100}\)
其 Jacobian \(\frac{\partial \mathbf{h}}{\partial \mathbf{x}} = W\),正好是一个 \(64 \times 100\) 的矩阵。
多层网络的 Jacobian 连乘与梯度消失#
对于深层网络,损失 \(L\) 对第 \(l\) 层参数的梯度等于每一层 Jacobian 的连乘:
关键洞察:Jacobian 矩阵的连乘是梯度消失/爆炸的数学根源。
如何理解 Jacobian 对梯度的影响?
想象 Jacobian 矩阵是一个"放大器"——它把输入的梯度变换成输出的梯度。我们用 \(\gamma\) 表示这个放大倍数[1]:
如果 \(\gamma < 1\):梯度被"缩小"了
如果 \(\gamma = 1\):梯度大小不变
如果 \(\gamma > 1\):梯度被"放大"了
对于简单的标量(单个数字),\(\gamma\) 就是导数的绝对值 \(\left|\dfrac{\partial h_{k+1}}{\partial h_k}\right|\)。
对于向量(多个数字组成的层),这个放大倍数可以用行列式(determinant)来理解——行列式的绝对值告诉我们:经过这个线性变换后,空间的体积被放大或缩小了多少倍。虽然 Jacobian 不一定是方阵,但核心直觉是一样的:每层都会对梯度进行"缩放"。
假设每层 Jacobian 的放大倍数为 \(\gamma\),经过 \(n\) 层连乘后,梯度的总体放大倍数为 \(\gamma^n\):
层数 \(n\) |
\(\gamma = 0.9\) (消失) |
\(\gamma = 1.0\) (稳定) |
\(\gamma = 1.1\) (爆炸) |
|---|---|---|---|
10 层 |
\(0.9^{10} \approx 0.35\) |
\(1.0\) |
\(1.1^{10} \approx 2.6\) |
50 层 |
\(0.9^{50} \approx 0.005\) |
\(1.0\) |
\(1.1^{50} \approx 117\) |
100 层 |
\(0.9^{100} \approx 2.6 \times 10^{-5}\) |
\(1.0\) |
\(1.1^{100} \approx 13,780\) |
梯度消失(\(\gamma < 1\)):
当 \(\gamma < 1\) 时,梯度呈指数级衰减
50层后衰减到 0.5%,几乎收不到梯度信号
浅层参数无法更新,网络退化为"浅层网络"
梯度爆炸(\(\gamma > 1\)):
当 \(\gamma > 1\) 时,梯度呈指数级增长
100层后放大 13,780 倍,数值溢出
参数更新剧烈,损失震荡发散甚至变成 NaN
实际神经网络中的 \(\gamma\) 值:
激活函数/技术 |
典型 \(\gamma\) 值 |
可训练深度 |
原因 |
|---|---|---|---|
Sigmoid |
\(\leq 0.25\) |
< 10 层 |
最大梯度在 0 处也只有 0.25 |
Tanh |
\(\leq 1.0\) |
< 15 层 |
比 Sigmoid 稍好,但仍会饱和 |
ReLU |
\(\approx 0.5\) |
20-30 层 |
负区间梯度为 0,正区间为 1(见 激活函数) |
BatchNorm |
\(\approx 1.0\) |
50+ 层 |
标准化梯度分布,稳定数值 |
跳跃连接 |
\(\approx 1.0\) |
100+ 层 |
提供梯度捷径,减少连乘长度(见 ResNet:高原反应补给站) |
关键结论:
只有当 \(\gamma \approx 1\) 时,深层网络才能稳定训练
从 Sigmoid → ReLU → BatchNorm → ResNet,每次突破都是让 \(\gamma\) 更接近 1
这就是为什么深层网络训练困难,以及残差连接和跳跃连接能缓解这个问题的数学原理。
与后面内容的衔接
下面"常见问题"部分会从更直观的角度解释梯度消失和爆炸,包括:
具体场景(什么时候会发生)
后果(对训练的影响)
解决方案(如何应对)
两部分内容互补:这里侧重数学原理(Jacobian 连乘),后面侧重实践指导。
示例:简单计算图#
考虑 \(f(x, y) = (x + y) \times y\),设 \(x=2, y=3\):
前向传播:
\(a = x + y = 2 + 3 = 5\)
\(f = a \times y = 5 \times 3 = 15\)
反向传播(假设损失对 \(f\) 的梯度为1):
\(\frac{\partial f}{\partial f} = 1\)
\(\frac{\partial f}{\partial a} = y = 3\)(乘法规则)
\(\frac{\partial f}{\partial y} = a = 5\)(乘法规则)
\(\frac{\partial f}{\partial x} = \frac{\partial f}{\partial a} \cdot \frac{\partial a}{\partial x} = 3 \times 1 = 3\)(链式法则)
\(\frac{\partial f}{\partial y}\) 有两条路径:\(= 5 + 3 = 8\)
PyTorch中的自动微分#
PyTorch通过autograd自动完成反向传播:
import torch

# 创建张量,启用梯度跟踪
x = torch.tensor(2.0, requires_grad=True)
y = torch.tensor(3.0, requires_grad=True)

# 前向传播
a = x + y      # a = 5
f = a * y      # f = 15

# 反向传播
f.backward()

print(f"∂f/∂x = {x.grad}")  # 输出: 3.0
print(f"∂f/∂y = {y.grad}")  # 输出: 8.0
关键机制:
神经网络中的反向传播#
对于多层神经网络,反向传播从输出层逐层回传:
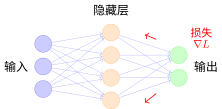
神经网络反向传播示意
流程:
前向传播:数据从输入层 → 隐藏层 → 输出层,计算预测和损失
反向传播:梯度从输出层 ← 隐藏层 ← 输入层,计算每个参数的梯度
参数更新:使用梯度下降更新权重
常见操作的梯度#
反向传播算法的实现依赖于定义每个基本操作的梯度规则。下面是神经网络中常用操作的梯度:
操作 |
前向 |
反向梯度 |
|---|---|---|
加法 \(z = x + y\) |
\(z = x + y\) |
\(\frac{\partial L}{\partial x} = \frac{\partial L}{\partial z}\), \(\frac{\partial L}{\partial y} = \frac{\partial L}{\partial z}\) |
乘法 \(z = x \times y\) |
\(z = x \times y\) |
\(\frac{\partial L}{\partial x} = \frac{\partial L}{\partial z} \cdot y\), \(\frac{\partial L}{\partial y} = \frac{\partial L}{\partial z} \cdot x\) |
ReLU \(z = \max(0, x)\) |
\(z = \max(0, x)\) |
\(\frac{\partial L}{\partial x} = \frac{\partial L}{\partial z}\) (if \(x>0\)), else 0 |
Sigmoid \(z = \sigma(x)\) |
\(z = \sigma(x)\) |
\(\frac{\partial L}{\partial x} = \frac{\partial L}{\partial z} \cdot z(1-z)\) |
更多激活函数的梯度定义,参见 激活函数。
反向传播的优势#
1. 计算效率#
反向传播算法的时间复杂度是 \(O(n)\),其中 \(n\) 是计算图中边的数量。相比之下,数值差分需要 \(O(n \times p)\),其中 \(p\) 是参数数量。
关键:通过复用中间计算结果,避免重复求导。
2. 模块化设计#
每个操作只需要定义:
前向:如何计算输出
反向:如何计算梯度
这使得添加新操作变得简单。
常见问题#
梯度消失(Vanishing Gradient)#
想象一个100层的神经网络。当你训练时,发现靠近输出层的参数更新正常,但靠近输入层的参数几乎不动——就像前面几十层"冻住"了一样。这就是梯度消失。
为什么会发生?回顾链式法则:梯度是各层影响的乘积。如果每一层的梯度都小于1(比如Sigmoid在饱和区的梯度只有0.01),100层连乘后:
这个数小到计算机都当成0处理了!具体场景是:使用Sigmoid/Tanh激活函数时,输入值很大或很小会让函数进入"饱和区",梯度接近0;网络层数越深,问题越严重。
后果:前面的层学不到东西,模型退化成"浅层网络"——只有后面几层在学习。对于图像数据,前面的层本应学习边缘、纹理等基础特征,但这些特征学不到。
解决方案:
ReLU激活函数:正区间的梯度恒为1,不会衰减(见 激活函数)
批归一化(BatchNorm):控制每层的数值范围,避免进入饱和区
残差连接(ResNet):让梯度有"捷径"可以直达前面层(见 ResNet:高原反应补给站 中的数学推导)
跳跃连接(U-Net):在编码器-解码器架构中保留梯度路径(见 U 形架构详解)
梯度爆炸(Exploding Gradient)#
训练过程中,损失突然变成NaN(不是数字),或者参数变得极其巨大(比如从0.1变成1000000),模型完全失控。这就是梯度爆炸。
为什么会发生?和梯度消失相反,如果每层的梯度都大于1(比如权重初始化过大,梯度为2),100层连乘后:
这是一个天文数字!参数会被更新得极其剧烈,完全偏离最优解。常见于权重初始化不当,或循环神经网络(RNN,详见 RNN的两个核心问题)处理长序列时的梯度爆炸。
后果:参数更新过大跳出最优解区域,损失函数震荡发散,甚至数值溢出(NaN)导致训练彻底失败。
解决方案:
梯度裁剪:设定梯度上限,超过就截断
权重正则化(L2正则):惩罚过大的权重
更好的初始化:如Xavier初始化、He初始化,控制初始梯度规模
更小的学习率:让参数更新更温和
总结#
反向传播是深度学习的核心算法:
信用分配:将最终损失"分摊"给每个参数
链式法则:梯度从输出层逐层回传(基于 计算图 的结构)
高效计算:复用中间结果,时间与网络规模线性相关
反向传播计算出的梯度用于更新模型参数。下一节 梯度下降与优化算法 将详细介绍如何利用这些梯度进行参数优化。
关于反向传播在实际神经网络训练中的应用,参见 训练基础:登山纪律。
参考文献
David E Rumelhart, Geoffrey E Hinton, and Ronald J Williams. Learning representations by back-propagating errors. Nature, 323(6088):533–536, 1986.
贡献者与修订历史


查看详细修订记录
-
bcbd7662026-09-04 - ThomasB: UI Bug fixes -
dc35df22026-06-14 - Heyan Zhu: refactor: unify into two-chapter mountain-climbing narrative -
e2bc8802026-06-13 - Heyan Zhu: fix: missing bib keys in pdf output -
d7c9da72026-05-12 - Heyan Zhu: docs: update sphinx only filter from not pdf to not latex -
a954ca52026-05-11 - Heyan Zhu: docs: revise and restructure documentation, fix formatting, and move env setup and sphinx guide to a separate appendix section -
8eb32752026-05-09 - Heyan Zhu: feat(sequence-modeling): add new chapter on sequence modeling from RNN to Mamba -
f159d562026-05-08 - Heyan Zhu: fix: address complaints from the linter -
15d1b152026-05-03 - Heyan Zhu: docs(model-architecture-design): add new chapter on CNN architecture design methodology -
b5e265a2026-04-28 - Heyan Zhu: docs(unet): restructure documentation and update content -
59126f42026-04-26 - Heyan Zhu: docs(math-fundamentals): update content structure and add citations