引言:从公式到代码#
理论你有了。打开编辑器的那一刻,你会愣住——784 个像素,10 个数字,从哪开始?
深度学习核心数学基础 给了你登山手册——计算图、反向传播、梯度下降。你读完了,理解了,甚至能徒手推导。
但打开一个空白的 .py 文件,面对 MNIST 的 784 个像素和 10 个数字——第一行写什么?
理论告诉你 CNN 更好。但"更好"这个词,在你亲眼看到全连接挣扎之前,只是一个抽象概念。登山者不读登山手册——他们爬山。摔了,才知道为什么需要更好的装备。
为什么是 MNIST?#
MNIST 是深度学习世界的"Hello World"。但和 Hello World 不同——它真的能教会你东西。
MNIST |
CIFAR-10 |
ImageNet |
|
|---|---|---|---|
样本数 |
70,000 |
60,000 |
1,400,000 |
图像尺寸 |
28×28 灰度 |
32×32 彩色 |
224×224 彩色 |
类别数 |
10 |
10 |
1,000 |
训练时间(单 GPU) |
几分钟 |
几十分钟 |
几天到几周 |
预处理需求 |
几乎为零 |
需要标准化 |
复杂流水线 |
它之所以是完美的练习峰,有四个原因:
小到可以快速迭代——一次训练几分钟,摔了立刻重来。你一天可以跑几十个实验,每个实验都让你更理解一个参数的意义。
干净到可以跳过干扰——图像已标准化,背景纯净,数字居中。你不用操心数据清洗、类别不平衡、多尺度目标。专注攀登技术本身。
直观到肉眼可验证——模型学到了什么?把卷积核画出来——哦,这个在找竖线,那个在找圆圈。人类一眼能懂。这种可解释性在更大的模型上会迅速消失。
历史意义——1989 年 LeNet 在这座山上首登。三十年后,这座山依然是验证新想法的第一站。它小,但不小到毫无挑战——全连接网络在这座山上也会摔。
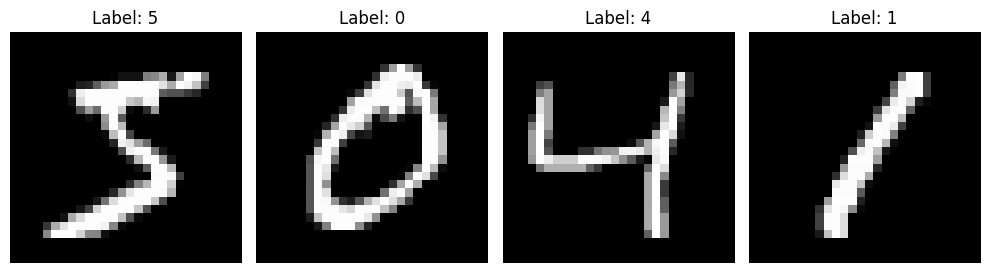
MNIST 手写数字样本#
登山者的先验知识#
你第一次攀岩时会怎么做?大概率是徒手试探每一块岩石——全身贴在岩壁上,手指抠进每一条裂缝,看看哪块石头能撑住体重、哪块会松动。
这就是全连接网络做的事。784 个像素,每一个都连到每一个神经元,不做任何假设,不信任任何结构。20 万个参数,就为了处理一张 28×28 的小图。
但经验丰富的登山者不会这样。他们看一眼岩壁就知道:
裂缝附近通常有稳固的支撑点——相邻像素是相关的,不需要检查全部
同样的攀爬动作在不同位置都有效——一个模式学会了,全图通用
岩壁的纹理是有方向的——水平边缘和垂直边缘需要不同的"读法"
这,就是归纳偏置(Inductive Bias)。
归纳偏置#
简单来说:把山的结构刻进装备里
归纳偏置是指学习算法对特定类型解决方案的偏好 [Mit80]。它不是代码里的 if 语句,而是架构设计隐含的"我先相信什么"。
攀法 |
归纳偏置 |
隐含假设 |
|---|---|---|
全连接(徒手) |
弱/无 |
每一块岩石独立存在,和周围没关系 |
CNN(冰镐+绳索) |
局部性 + 平移不变性 |
相邻岩石连在一起;同一技巧到处适用 |
为什么好的先验是作弊器?
数据效率:好的偏置让你用更少的尝试找到规律
全连接:必须看到数字"7"出现在图像左上角、右下角、中间……每个位置都学一遍
CNN:学到一个位置的"7",自动在所有位置认出它——平移不变性
参数效率:好的偏置让每一克负重都值得
全连接第一层:784 × 256 + 256 = 200,960 个参数
CNN 第一个卷积层(32 个 3×3 核):32 × (3×3×1 + 1) = 320 个参数
差距超过 600 倍。不是 CNN “更聪明”——是它"更信任山的结构"
泛化能力:好的偏置反映的是物理世界的客观规律,不是训练集的偶然噪声
贝叶斯视角#
简单来说:先验就是信念
从贝叶斯统计的角度,归纳偏置就是先验知识——看到数据之前,你已经相信的东西:
概念 |
含义 |
在 CNN 中的体现 |
|---|---|---|
先验 |
看到数据前的信念 |
“相邻像素相关,卷积核应该局部连接” |
似然 |
数据对假设的支持程度 |
训练样本告诉你哪些特征对分类有用 |
后验 |
看到数据后更新的信念 |
学到的具体卷积核权重——先验 + 数据的融合 |
为什么先验重要? 想象猜一枚硬币:
无先验(全连接): 看到 3 次正面,就断言"这硬币 100% 正面"(过拟合了)
有先验(CNN): 你本来就相信硬币大致公平;3 次正面只是随机波动(泛化好)
CNN 的归纳偏置就是给模型一个"登山老手的直觉"——还没开始爬,就知道该注意什么。好的先验让后验更快收敛到真相,且需要更少的数据。
一句话
全连接是每遇到一个"7"都当全新符号教一遍。
CNN 是教一次"7"的特征,孩子自动在任何位置认出它。
好的架构,让学习事半功倍。因为你把山的形状,刻进了装备里。
登山上篇路线#
        graph TD
    A["① 赤手空拳<br/>全连接:20万参数走不远"] --> B["② 发现装备<br/>CNN:顺应山体结构"]
    B --> C["③ 打包行囊<br/>数据流水线"]
    C --> D["④ 登山纪律<br/>训练法则"]
    D --> E["⑤ 🟢 首登!<br/>LeNet 证明可行"]
    E --> F["⑥ 登山日志<br/>实验验证"]
    F --> G["🏁 登顶回顾<br/>指向消融和登山下篇"]

    style E fill:#4CAF50,color:#fff
学完登山上篇,你将能够#
登山上篇目标
理解归纳偏置:为什么 CNN 比全连接更适合图像(归纳偏置 的胜利)
实现:用 PyTorch 搭建全连接网络和 CNN
训练:掌握调试技巧——损失曲线、学习率、正则化
验证:用实验数据检验理论(山不会听你嘴硬,山只看数据)
登顶:完整走通从赤手空拳到 LeNet 首登的全过程
前置提醒
深度学习核心数学基础 是上一篇——计算图、反向传播、梯度下降。本章是它的实战延伸:
参考文献
Tom M Mitchell. The need for biases in learning generalizations. Technical Report, Department of Computer Science, Laboratory for Computer Science Research, Rutgers University, 1980.
贡献者与修订历史

查看详细修订记录
-
ea7e1062026-06-16 - Heyan Zhu: fix: cross-ref syntax, formulas, code, and structure across 5 chapters -
dc35df22026-06-14 - Heyan Zhu: refactor: unify into two-chapter mountain-climbing narrative